
I et studie, der retoucherer produktbilleder dag ud og dag ind, er metadata det, der gør forskellen på et arbejdsarkiv og en bunke filer. Selve pixlerne er den nemme del. Det er felterne omkring billedet - SKU, kampagne, retoucher, licens, version - der afgør, om I overhovedet kan finde det rigtige hero-shot, når kunden ringer otte måneder senere.
De fleste studier får aldrig sat sig ned og tegnet et metadata-skema fra bunden. Fotografen skriver et par IPTC-keywords ved ingest. En retoucher opfinder et statusflag, fordi der manglede ét. En producer tilføjer en kolonne i sit projektark. Et halvt år senere har I tre halvfærdige taksonomier, ingen af dem komplette, og søgefeltet i jeres DAM er blevet et gættespil.
Den her artikel beskriver det skema, den governance og den eksport-disciplin, vi gerne så studier havde fra dag ét.
De fire metadata-lag, ingen produktfoto-asset bør mangle
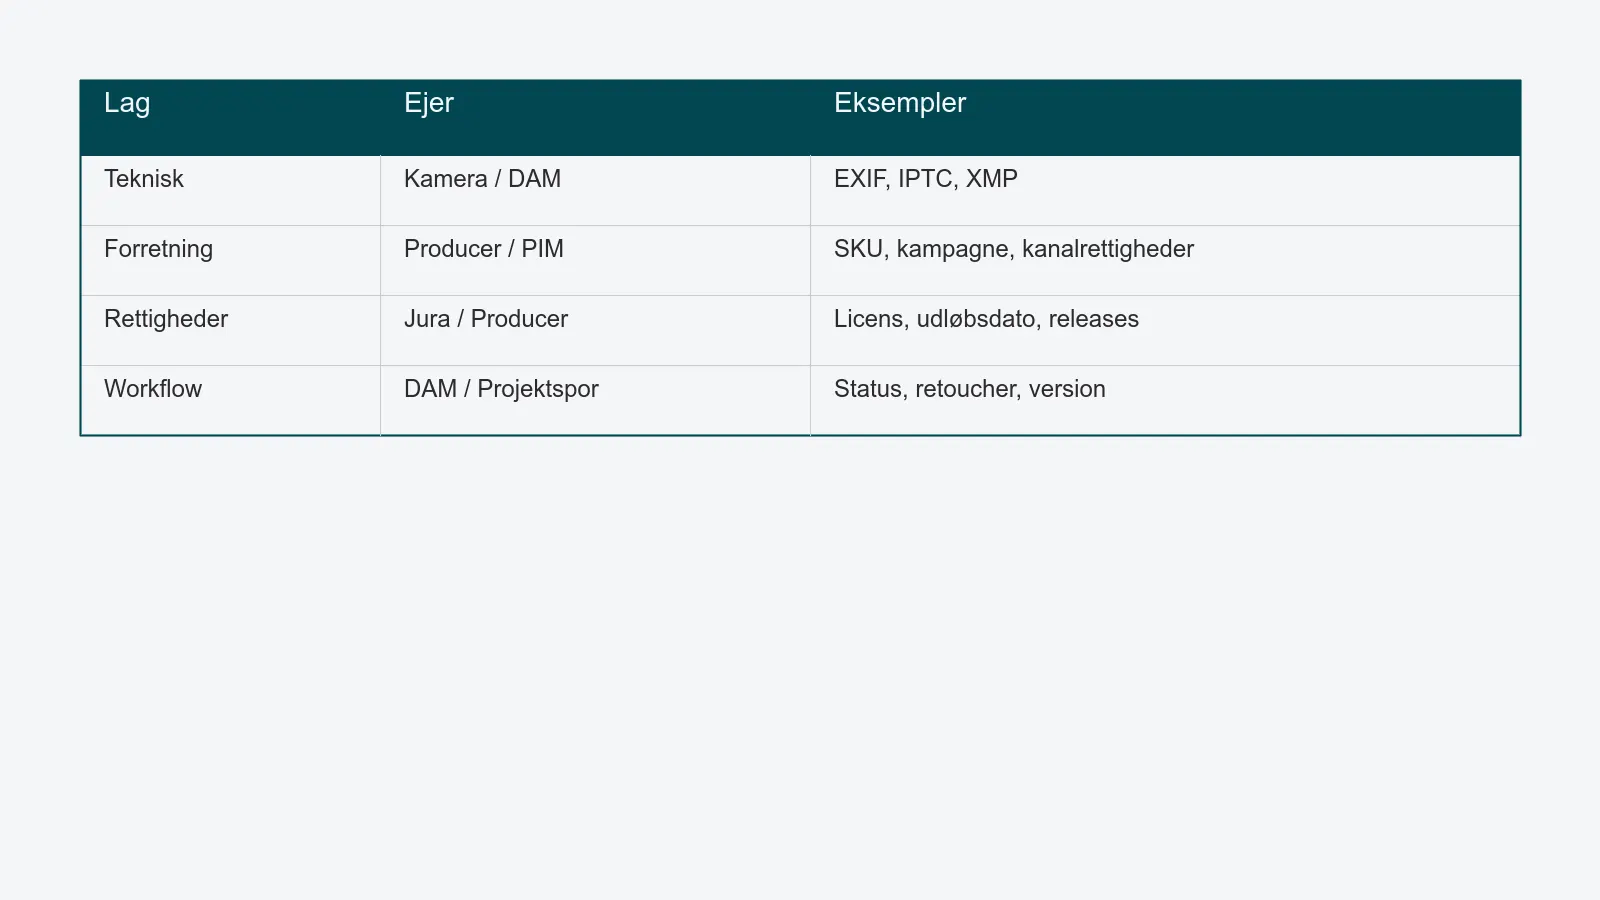
Et komplet metadata-record på et produktbillede er ikke en flad keyword-liste. Det er fire lag, der overlapper, og hvert lag har sin egen ejer og sin egen livscyklus.
Teknisk metadata er det, kameraet og redigeringssoftwaren skriver helt af sig selv. EXIF holder optagelsesfakta: kamerahus, objektiv, ISO, lukkertid, blænde, optagelsestidspunkt, farverum. IPTC og XMP holder de redaktionelle felter: headline, beskrivelse, ophavsperson, copyright, keywords, lokation. Det meste skriver sig selv, hvis tethered capture er sat ordentligt op - men kun så længe ingen stripper det igen længere nede i pipelinen.
Forretningsmetadata er det, der gør billedet kommercielt brugbart. SKU eller stilnummer, kampagnekode, sæson, kollektion, kanalrettigheder (web, print, social, retail-partner, kun internt), lanceringsdato, region. Intet af det findes i kameraet. Det skal lægges på ved ingest - ofte manuelt, men i stigende grad via opslag mod jeres PIM. Det er det lag, jeres kunder reelt søger på.
Rettighedsmetadata holder juraafdelingen ude af jeres indbakke. Reference til model release, property release, licenstype, udløbsdato, begrænsede markeder, eksklusivitetsperioder, tredjepartsklareringer. En manglende udløbsdato her er forskellen på "vi leverede til tiden" og "vi betalte et forlig".
Workflow-metadata beskriver, hvor billedet er i produktionen lige nu. Status (raw, i retouchering, i QA, godkendt, publiceret, arkiveret), tildelt retoucher, QA-godkender, versionsnummer, parent-asset, afledningskæde. Det er det lag, hvor DAM'en og projektsporingen kommer på kant - og det skal være de samme værdier begge steder, ellers stemmer regnskabet ikke.
Hvis bare ét af de fire lag er svagt, går de andre i opløsning over tid. Stærke tekniske felter uden rettighedsstyring sender stadig udløbne modeller ud af huset. Stærke workflow-felter uden forretningsfelter betyder, at ingen kan finde billedet på SKU. Skemaet skal dække alle fire lag - også selv om nogle af dem starter i en simpel udgave.
Indlejret kontra sidecar - hvor felterne reelt bor
Metadata kan ligge to steder: inde i selve filen eller i en sidecar. En sidecar er enten en .xmp-fil ved siden af billedet eller en række i jeres DAM-database. Begge dele er legitime. Det går først galt, når studiet lader som om valget ikke betyder noget.
Indlejret metadata følger med filen ud af huset. Sender I en TIFF til en ekstern retoucher, så ryger IPTC-headline, ophavsperson, copyright og eventuelle XMP-felter med. Bagsiden er, at ikke alle filformater bærer alle felter lige godt. JPEG og TIFF er pålidelige. PSD er selektiv. Raw-formater varierer fra producent til producent.
Sidecar-metadata bliver liggende i det system, der skrev det. DAM'en er den kanoniske kilde. Fordelene er åbenlyse: relationelle felter, multi-value-attributter, audit trails, validering mod et kontrolleret vokabular. Bagsiden er lige så åbenlys: i samme øjeblik filen forlader DAM'en, følger sidecaren ikke med.
Det praktiske svar er begge dele med et hierarki. DAM'en er sandhedskilden. Ved hver eksport skriver DAM'en et defineret udsnit af felterne tilbage i filens IPTC- og XMP-blokke, så modtagerne længere nede - PIM'et, e-handelsplatformen, en ekstern retoucher, en syndikeringspartner - ser de samme værdier som jer. Når filen kommer retur, læser I de indlejrede felter og afstemmer mod DAM'en. Felter, der ikke overlevede tur-retur, skal udløse et flag - ikke tavst datatab.
Taksonomi-styring: faste lister kontra fri tagging
En taksonomi er bare en liste over tilladte værdier for et felt. "Varegruppe" kan være fritekst - og så er halvdelen af arkivet tagget "jakke", en tredjedel "Jakke", og en lille genstridig gruppe "jacket". Eller den kan være et kontrolleret vokabular, hvor feltet kun accepterer værdier fra en kurateret liste.
Kontrollerede vokabularer er ikke til diskussion på de felter, jeres kunder rent faktisk søger på. Varegruppe, farve, sæson, kanal, status. Listen er kort, ejet af én person, og den er versioneret. Når I tilføjer en værdi, sker det med vilje. Når I udfaser en værdi, hører der en migrering med, der opdaterer alle eksisterende billeder.
Fritagging har også sin plads. Det er hurtigt, det fanger den lange hale, og det fanger begreber, det kontrollerede vokabular ikke har tænkt på endnu. Det rigtige mønster er en hybrid: lad retoucherne fritagge ved ingest, og kig listen igennem ved et kvartalsreview. De frie tags, der dukker op igen og igen over en tærskel, bliver løftet ind i det kontrollerede vokabular. Resten må gerne blive uformelle.
Versionering af taksonomien er det, de fleste studier glemmer. Den taksonomi, I definerede i 2023, er ikke den, I sender ud i 2027. Nye produktlinjer, nye kanaler, nye compliance-krav - alt sammen ændrer feltlisten. Hver ændring skal have et versionsnummer, en ikrafttrædelsesdato og en migreringsplan for de billeder, der allerede er tagget i den gamle version. Uden versionering er spørgsmålet "find alle billeder tagget 'bæredygtig', før vi strammede definitionen" ikke til at besvare.
Den samme disciplin gælder for auto-tagging af produktbilleder. En AI-model, der skriver ind i jeres taksonomi, skal igennem samme review, samme audit trail og samme udfasningsplan som ethvert menneske. Et tag er et tag, uanset hvem der har sat det.
Auto-tagging med retoucheren som sidste filter
Manuel tagging i industriel skala kan ikke betale sig. Ren auto-tagging kan I ikke stå inde for. Det, der reelt fungerer, er automatisering med en retoucher som sidste led.
Vision- og sprogmodellerne i PixelAdmins AI-modul foreslår tags med en confidence-score op mod jeres taksonomi. Ligger scoren over en defineret tærskel - typisk 0,9 for farve, 0,85 for varegruppe, 0,7 for materiale - bliver tagget skrevet direkte på billedet. Ligger den under, dukker tagget op i den gennemgang, retoucheren alligevel laver, når QA-runden kører. Retoucheren bekræfter, retter eller afviser, og hver beslutning logges på billedet.
Resultatet er, at de fleste billeder bliver tagget på sekunder uden at nogen rører dem, mens de billeder, der kræver dømmekraft, får den fra den person, der allerede sidder med pixels på skærmen. Audit-trailen er komplet, taksonomien forbliver ren, og retoucheren drukner ikke i rutinearbejde.
For studier, der stadig er i tvivl, om laget overhovedet er nødvendigt, er forudsætningen at have læst hvad er en DAM. Auto-tagging uden en rigtig DAM under sig er bare en tag-motor, der skriver ud i ingenting.
Sådan holder I metadata i live gennem hele eksporten
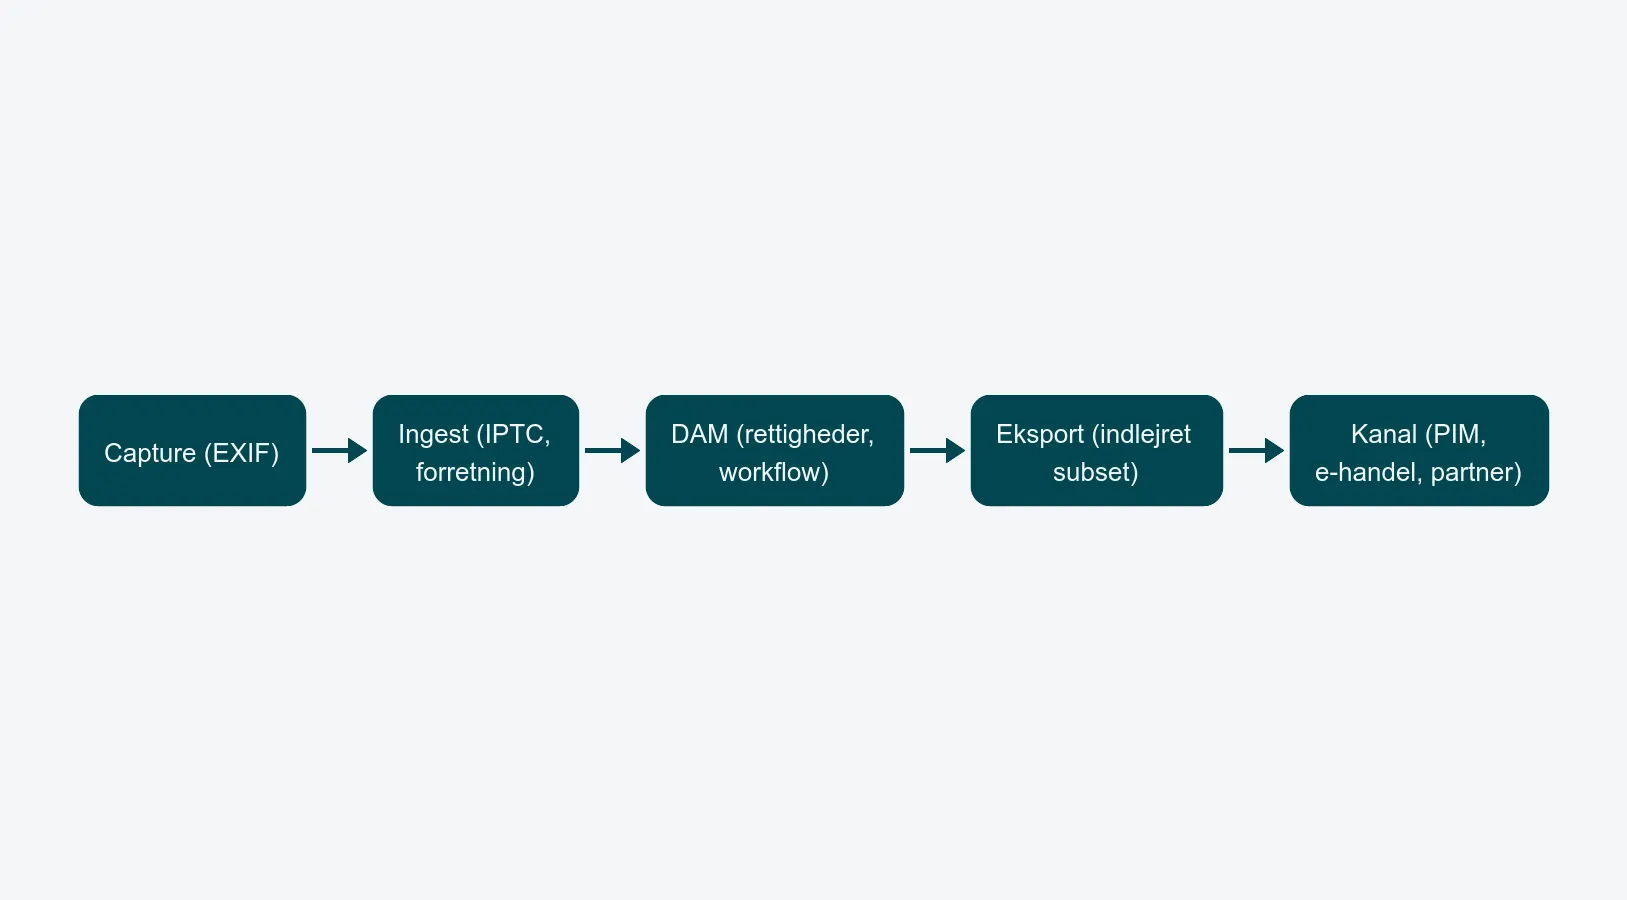
Den hyppigste metadata-fejl er ikke dårligt input. Det er tavs stripning på vej ud. DAM'en har en perfekt record. Billedet leveres til en partner. Felterne er væk.
Tre ting stripper metadata, cirka i den her hyppighedsrækkefølge.
Billedoptimeringsværktøjer. De fleste CDN-pipelines, billedresizere og "save for web"-presets fjerner EXIF, IPTC og XMP som default for at spare et par kilobyte. Løsningen er en pass-through-profil: en defineret liste over felter, optimeren skal bevare, også selv om det koster et par ekstra kilobyte. Copyright, ophavsperson og rettighedsudløb må aldrig være valgfrie felter.
Formatkonverteringer. Når I går fra TIFF til JPEG, fra PSD til TIFF eller fra raw til hvad som helst, taber I felter, hvis eksportværktøjet ikke mapper dem eksplicit. Definér eksportprofilen i DAM'en, ikke i eksportværktøjet. Så ryger de samme felter med ud hver gang, uanset hvilken retoucher der trykker på knappen.
Overgange ved kanallevering. E-handelsplatformen, PIM'et og jeres social scheduler har hver deres egen metadata-model. Nogle modtager IPTC. Nogle vil kun have felter pushet via API. Nogle dropper stille alt, der ikke står i deres eget skema. Det rigtige mønster er en integrationsprofil pr. kanal: hvilke DAM-felter mapper til hvilke kanalfelter, hvad bliver indlejret i filen, og hvad rejser ved siden af som API-metadata.
Kan I ikke i ét afsnit svare på, hvilke af jeres felter der overlever hver enkelt eksportvej, så har I ikke en metadata-strategi. I har en forventning.
En kort tjekliste, før I fryser skemaet
- Dæk alle fire lag - teknisk, forretning, rettigheder, workflow - også hvis nogle starter småt.
- Vælg de kontrollerede vokabularer, før I vælger værktøjerne. Værktøjer håndhæver et skema; de opfinder ikke et for jer.
- Bestem hvilke felter der indlejres, og hvilke der bliver liggende som sidecar. Skriv reglen ned.
- Versioner taksonomien fra dag ét. Hver ændring får et nummer og en migrering.
- Audit én komplet eksportvej pr. kvartal og bekræft, at metadataen kommer hel ud i den anden ende.
Metadata er det billigste sted at gøre arbejdet ordentligt og det dyreste sted at rydde op senere. Få skemaet rigtigt, styr taksonomien ærligt, og behandl hver eneste eksport-pipeline som et sted, hvor felter kan forsvinde uden at sige fra - så begynder arkivet at akkumulere værdi i stedet for at forfalde.
Vil I se det køre på jeres egne studie-assets, så book en metadata-gennemgang. Vi gennemgår jeres nuværende skema, præcisionen på jeres auto-tagging og de eksportveje, der stille stripper felter i dag.